
搜索源没有稳定发布时间时,代码用“现在”顶上;下游又拿这个字段做 3 天过滤,结果旧闻永远不会过期。
上周给一个模拟研究项目加第五路资讯源。代码还没接完,先在旧管道里翻到一个很别扭的问题:
一条三个月前的旧闻,能被当成今天的新消息。
不是模型编的。标题、链接、摘要都是真的。错的是我给它盖的时间戳。
先交代一下项目
这是一个模拟研究项目,不接实盘,也不做自动交易。它主要做三件事:
- 维护关注列表
- 每天早上、午间、晚上跑资讯管道
- 把官网公告、公开快讯、机构页面和搜索结果汇总,去重后交给模型做摘要
原来的数据源有四路:
- 官网公告,权威性最高
- 公开快讯,负责时效
- 机构页面,有列表地址才抓
- 可选搜索源,只取标题、链接和摘要
没有新增内容时,就跳过模型,省一点调用费。去重也不算缺:
- 用对象编号、标题和摘要生成内容指纹,做精确去重
- 同一关注对象近 3 天,同 URL 或标题高度相似视为重复
- 来源优先级:官网 > 机构页面 > 快讯 > 搜索源
这套东西一直能跑。直到我准备再加一路 DeepSeek Search / Fetch。
问题不在模型,在时间字段
旧搜索源返回的引用里没有稳定的发布时间。当时图省事,转换时直接写成了:
publish_time:当前时间crawled_at:没有单独存
下游又用 publish_time 做 3 天过滤:
- 如果
publish_time是今天,就认为内容是新的 - 如果早于 3 天,就丢掉
两段逻辑放一起看,问题就露出来了:
| 字段 | 本来应该表示 | 实际变成了 |
|---|---|---|
publish_time | 内容发布时间 | 我抓到它的时间 |
crawled_at | 抓取时间 | 没有单独存 |
任何一条旧内容,只要从这一路进来,都会被盖上今天的时间戳。3 天过滤看到的是“现在”,自然永远放行。三个月前的旧闻,也会被当成刚刚发生的事。
更麻烦的是,去重也拦不住。URL 可能是新的,标题可能没有完全重复,内容指纹自然也不同。它不会以“重复内容”的形式出现,而会以“今天的新消息”的形式出现。
内容是真的,链接也是真的。错的是时间语义。
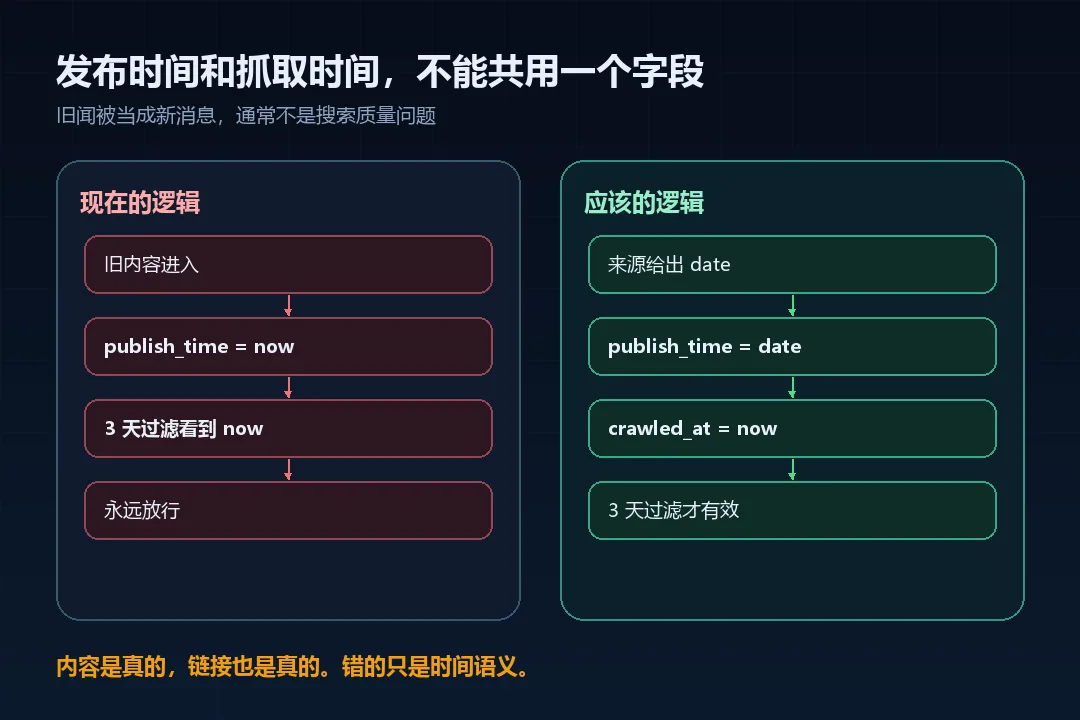 发布时间和抓取时间分开存,3 天过滤才有意义
为什么这个 Bug 很危险
时间不是附属字段,它本身就是内容的一部分。
一条“某产品获认证”的消息,如果是昨天发的,可能值得关注;如果是三个月前发的,今天再拿来判断,结论可能完全反过来。旧政策、旧项目、旧合作,都一样。
更糟的是,它会影响后面的分析。你以为模型在总结今天的信息,其实它拿到的是几个月前的旧闻。
而且它很安静。管道不报错,日志里有新增,模型也能给出像模像样的摘要。只有你点开链接,看到发布时间,才会发现哪里不对。
不用接 DeepSeek,也能验证
拿一条三个月前的旧链接,构造一条待入库内容,把 publish_time 手动设成当前时间,再走一遍批量入库。
如果它能进去,说明时间过滤已经被绕过去了。
这跟搜索质量没关系,测的是字段语义。搜索源换成 DeepSeek、旧搜索源还是别的,逻辑都一样:谁把抓取时间写进 publish_time,谁就会制造“今天的旧闻”。
修复的第一步:把两个时间拆开
我现在按这三条处理:
publish_time只放来源明确给出的发布时间crawled_at单独记录抓取时间- 拿不到发布时间,就标记为
time_unknown,不要用“现在”冒充
没有发布时间的结果,可以丢弃,也可以进入“待核验”队列,但不能直接进入当天的摘要。
第二步才是接 DeepSeek。
DeepSeek Search 的返回里有 date 字段,可能是空值。查询里也可以带 after:,让搜索引擎先做一轮时间过滤:
- 对象名 + 编号 + 公开信息 +
after:2026-10-16 - 对象名 + 编号 + 官网公告 +
after:2026-10-16
after: 不是万能的,但它能挡掉大部分明显过期的结果。剩下的,还是要自己在入库前判断。
接入方案:先定字段,再跑通 Demo
我打算新增一个搜索源适配器,接口参考现有的搜索源,但不和正在做的重构混在一起。
适配器只做四件事:
- 对每个关注对象拼 query
- 调 Search 接口
- 只保留标题、链接、摘要、发布时间、权威度和相关性分数
- 转成统一入库结构,复用原来的去重
转换时,字段关系要明确:
| 来源字段 | 入库字段 | 规则 |
|---|---|---|
搜索结果的 date | publish_time | 有值就用,空值不猜 |
| 当前时间 | crawled_at | 单独存 |
没有 date | time_unknown | 待核验或丢弃 |
过滤规则分两层:
- 通用层:按相关性和权威度过滤,低分结果直接丢掉
- 业务层:官网、机构页面加权;聚合站、内容农场降权
第二层不能省。搜出来的内容和值得相信的内容,是两件事。
Fetch 只用来核,不用来囤
Search 找到候选后,不是每条都要 Fetch。
我只会对两类页面打开正文:
- 官网公告、机构页面这类公开披露页面
- 需要核对关键数字或事件细节的高权威来源
Fetch 回来的正文只用于抽取 200 字以内的摘要和事件要素,原文不落库。普通内容站点直接用 Search 返回的 snippet 或 summary,够用就行。
这不是技术选择,是项目合规文档的硬约束:
- 内容只保存标题、发布时间、来源、摘要
- 不存储完整正文
- 7 天自动清理
- 自建抓取部分仍是单线程、单域名间隔至少 10 秒
- 403 / 429 立即停止本轮并休眠
- 只做内容聚合和研究
Search 是用来找的,Fetch 是用来核的,不是用来囤的。
成本粗算:别按关注对象数量算,按调用数算
假设每天 1,000 个 query:
- Search:1,000 次/天
- 每个 query 只 Fetch 3 条:3,000 次/天
- 合计 4,000 次/天
按 5 元 / 1000 次成功请求算,大约 20 元/天,600 元/月。
如果每个 query Fetch 5 条,就是 6,000 次/天,约 30 元/天,900 元/月。
这是估算,不是账单。真实成本还要看重试、缓存命中率和重复抓取。但至少能看出一个顺序:先把 Search 的候选筛干净,再决定 Fetch 多少条。
限流也得提前想。Search 100 QPS、Fetch 25 QPS,都是账号级;Fetch 还有单域名限制。开几十个并发直接打,日志里很快就会全是 429。
我的做法是 Search 和 Fetch 分队列,Fetch 单域名并发压低,429 走指数退避,所有请求都带超时。内容聚合不是实时系统,晚 30 秒不会出事;整轮被限流,才是真的跑不完。
最后
加一个新搜索源,技术上不算难。麻烦的是让新旧内容落在同一条时间线上。
旧闻被当成新消息,看着像搜索源的问题,其实是字段语义没分开。publish_time 和 crawled_at 混在一起,后面加多少个数据源都不安全。
这套改动我还没合并,先把方案写清楚,没打算写成“已经上线”。但至少现在知道,接 DeepSeek 之前,得先把原来那行“现在”改掉。
项目代码不公开,这篇文章只保留通用方案和字段示意,不贴仓库实现。
同名公众号:攻城狮很饿。
本文只讨论模拟/研究系统,不构成任何投资建议。